ce-babysit-pr tick
看护一个打开中的 PR 的长跑 tick 引擎。先判断旧 PR 是否还该更新,再进入三种姿态、8 步 tick、分支保鲜规则、settle 判断、托管 stack 巡游。
ce-babysit-pr 是本插件中唯一的长跑 tick 循环。它在进入看护前先跑一次 旧 PR 归属判断(intake),每次 tick 跑一次,在真正停止(terminal / looks-ready / budget / blocked-external-drained)和常驻残余(needs-human / blocked-failing / stack-blocked,阻断 ready 宣告但不结束循环)之间做判断。它把反馈委托给 ce-resolve-pr-feedback,把CI委托给 ce-debug,把描述刷新委托给 ce-commit-push-pr。它自身不开启 CI 看护、不自跑轮询,也永远不说"可以合并"。
旧 PR 归属判断(intake)
base 移动之后,PR 可以干净地 rebase 却已经不再属于主线:base 可能已经解决了同一个问题,或者把 PR 要改的代码删除、移动或刻意简化了。git 冲突只显示文本重叠。intake 在任何推送之前判断这个 PR 还该不该更新,并且持有 babysit 唯一一次历史改写。
每次全新调用在 checkout 门之前跑一次;checkpoint 恢复、调度器重入和 stack 层过渡跳过它,长跑中途不改变结论。看护进行中用户要求更新、rebase 或重新评估时,停掉 watcher、跑这一步、再继续。
重叠检查与评估
SKILL_DIR="<ce-babysit-pr 技能目录绝对路径>"; PY=python3
"$PY" "$SKILL_DIR/scripts/intake-overlap" --repo-dir "$(git rev-parse --show-toplevel)" \
--remote "<base-remote>" --base "<baseRefName>" --pr "<N>"--remote传 PR URL 所属 base 仓库对应的本地 remote;fork checkout 里它常常不是origin。- 输出的
overlap为true/unknown,或用户主动要求更新、rebase、询问是否还值得保留时,才做评估;否则直接进入 checkout 门。 - 年龄、落后多少提交、距上次活动多久都不触发评估,也永远不作为判定证据。
- 评估只读:从检查取到的 base 与 head OID 出发,看 PR 意图、base 自 merge-base 以来的变化(同一问题已被解决、代码被移动/删除/刻意简化、API 或归属边界变化、落地会复活已删行为或造出第二条同义路径),再搜有没有替代实现。
- 干净的 merge 或 rebase 永远不是"这个 PR 还是新的"的证据;沉没成本永远不是保留它的理由。
三选一判定
| 判定 | 含义 | 交互式运行 | 无人值守(mode:pipeline) |
|---|---|---|---|
| Update | 目标仍有用,实现形状仍对 | 进入 checkout 门;用户的话授权改写时才做 verified update | 静默进入普通看护,永不改写 |
| Rework | 目标有用,但机械更新会留下错误实现 | 说出最小可信的重构方案后停止,不启动 watcher | 返回 needs-human 结果 |
| Close | PR 已被取代、过时、方向错或不值其成本 | 附证据建议关闭并停止;关闭必须用户明确同意 | 返回 needs-human 结果 |
intake 自己永远不把 base 合入 PR——在 CLEAN PR 上那正是快照会上报的 unrequested_base_merge 缺陷。Rework/Close 判定下用户回答"保留"或"照看它",本次调用继续进入 checkout 门;下一次全新调用重新评估。
改写授权与 verified update
rebase + force-push 只由用户自己的话授权:本次调用要求更新或 rebase、看护中途的实时消息、或对"要不要 rebase"这一次询问说 yes。协调者文本、调用方 token 和委托结果都不授予它;无条目的"update the branch"是扩权而不是收权。委托方仍保留 rebase/force-push 排除项,改写只属于 babysit。一次授权只覆盖一次改写,之后的 base 移动照常走分支保鲜。
- verify 前先记录起点:从 head 仓库分支读 head SHA 并用私有本地 ref 留存,使其可恢复。
- 在临时 worktree 里把 PR rebase 到刚取回的 base,冲突按 PR 意图与 base 新规则解;暴露产品或架构分歧的冲突会中止 rebase 并重开判定。
- 推送前用
git range-diff比较新旧提交序列并读最终 diff:意图变化不得消失,base 已落地的东西不得回来。空 diff、或提交被当作"上游已应用"丢弃 → 重开判定(那正是 Close 的证据)。 - 用租约推送:
git push --force-with-lease=<head-branch>:<recorded-sha>。被拒一次则重新取数、换起点重做;第二次被拒说明分支正被他人推送,报告并停止。 - 不改写已确认的托管 stack 层、
probe-error的 PR、或 head 被另一个打开 PR 当作 base 的 PR。 - 无法推送时改用接管:
references/takeover.md。
三种姿态
每次运行选择一种姿态,写成 posture:target|stack-ready|stack-land。每次托管 stack --continue-invocation 都要重新声明。
| 姿态 | 行为 | 会合并吗? |
|---|---|---|
| target | 只看指定的那一个 PR。在 looks-ready 处停止。若确认的托管 stack 还有工作要做,仅主动提议一次 stack-wide;用户拒绝则保持 target-local。 | 从不 |
| stack-ready | 一旦当前活跃层进入 静止态(零可执行积压 + 无常驻残余 + 无进行中的委托),上移到下一个打开的、非草稿的、更上层的层。下方各层留在 downstack 探针之下;最底下一层若重新打开,就把巡游拉回来。 | 从不 |
| stack-land | 巡游行为与 stack-ready 相同。选择它即是合并授权。一旦最底部的打开层看起来 ready:gh run <that-PR> --yes --squash + gh stack sync。然后继续。 | 会(最底部打开且已 settle 的层) |
选择方式:只点了一个 PR 而无 stack 措辞 → target(但若存在确认的多层托管 stack,问一次);显式 stack 意图 → stack-ready;"landing-and-merge" 意图 → stack-land。mode:pipeline 永不询问。
8 步 tick(顺序是不变量)
一次 tick = 严格按以下顺序执行。顺序就是契约。
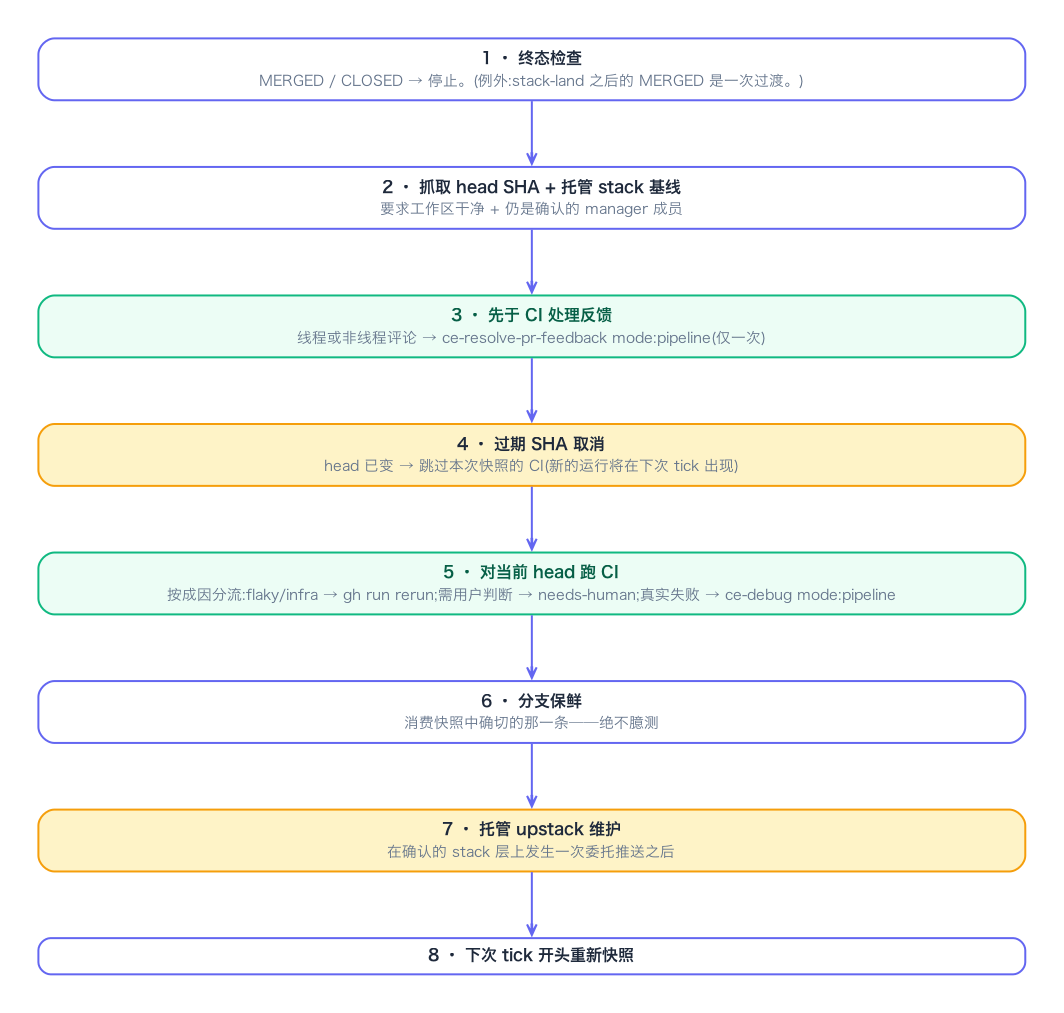
各步骤详解
步骤 1 — 终态检查
快照中 pr_state 为 MERGED 或 CLOSED → 停止并报告。唯一例外:当本次运行刚刚完成对该 PR 的已授权 stack-land 合并时,把 MERGED 视为托管 stack 的层过渡,而不是运行级的终态停止。
步骤 2 — 抓取基线
记录快照的 head_sha;对确认的托管 stack,还要从 gh stack view --json 记录一条可恢复的基线:在目标分支之上或同一层级的、由 manager 排序的打开分支,以及每个分支的 remote-tracking OID。工作区干净 + 仍是确认的 manager 成员是前提。
步骤 3 — 先于 CI 处理反馈
若 counts.threads > 0 或 counts.comments > 0,调用 ce-resolve-pr-feedback mode:pipeline <pr-ref> 恰好一次。当 trajectory 触发器命中(invariant_rounds[]. = 2、积压上升、重复簇等)时传入 trajectory。每个 tick 仅做一轮 resolve——绝不扇出。
对每一条返回的类型化 needs-human:在 ## Needs Needs your decision 下渲染完整 payload,通过 pr-snapshot mark --residual-file <path> --disposition needs-human 持久化,保留被覆盖的线程为打开状态。
对每一条你传入但没有返回类型化残余覆盖的评论进行核对:mark --disposition dispatched(若是 fix 结果则用 --invariant-key)。
步骤 4 — 过期 SHA 取消
将抓取的 head SHA 与当前 SHA 对比。若它移动过,说明评论轮(或别人)推送了;本快照里的 CI 失败都针对的是一个过期的 SHA——不要据此行动。新的运行将在下次 tick 出现。
步骤 5 — 对当前 head 跑 CI
把所有可执行的失败检查聚合成一轮修复处理。不要按检查逐条派发;每条按其成因分流——重跑、置为 needs-human 残余,或交给 ce-debug。
- Flaky/infra(已知 flaky 任务、infra/超时信号):从失败检查的
details_url中抽取 run ID 与完整基础仓库(含 host),执行gh run rerun <run-id> --failed -R <host>/<owner>/<repo>。无人值守时必须传入 run ID——省略它会让gh run rerun退化为交互式 run-picker 菜单。 - 真实测试/构建失败:以失败任务及其日志尾部为种子调用
ce-debug mode:pipeline一次。CI 触发器命中时传入trajectory。status必须恰好是fixed-and-pushed|fixed-not-pushed|flaky-infra|needs-human|diagnosed-no-fix之一。 - 需要用户判断的失败:不派修复,直接落为 needs-human 残余并在报告中点名;未修复的检查保持红色残余。
- 永远不要为了让它通过而削弱、跳过或 mock 失败的断言。
步骤 6 — 分支保鲜
消费快照所发出的、当前 branch_currency 那一条;没有条目就不要做任何 base-into-head 变更。完整路由、声明生命周期以及 BEHIND/DIRTY 机制详见 references/branch-currency.md:
BEHIND:仅由 host 主导的更新。调用PUT /repos/{owner}/{repo}/pulls/{number}/update-branch并设置expected_head_sha。HTTP 422 head mismatch = 过期声明;重新快照并核对。DIRTY:仅做基于精确 base 的本地修复。预览冲突;若属机械性(具有正向意图证据,无合理替代方案),合入精确的 base OID,标记--currency-outcome mutation-observed,正常推送。永远不要 rebase 或 force-push。unrequested_base_merge:一种缺陷检测器——有人在 CLEAN PR 上无声明就把 base 合入了,绿色 CI 重新开始跑。上报它,永远不要撤销它,也永远不要把由此造成的"检查重跑时的BLOCKED"当成新的 blocker。
步骤 7 — 托管 upstack 维护
在确认的托管 stack 上发生一次委托推送之后,维护 upstack:重新执行 gh stack view --json,从其 tracking remote 拉取目标,验证目标的本地 head + remote-tracking tip 仍等于已推送的 SHA,然后执行 gh stack rebase "<first-dependent-branch>" --upstack --no-trunk --remote <tracking-remote> + gh stack push --remote <tracking-remote>(永远不要用原始 git push --force)。若发生冲突,立即 gh stack rebase --abort 并上报一个 needs-human/stack-sync 残余——不要在另一 PR 层上决定冲突语义。
步骤 8 — 重新快照
任何变更之后,在下次 tick 开头重新快照,并传入相同的 --invocation-id、--session-started-at 与 --invocation-budget-seconds。head SHA 与 CI 全集已变;调用级的预算未变。不要在一次 tick 中途再跑一次 snapshot 来重新派生 CI——这正是造成过期 SHA 混乱的根因。
停止条件
| 类别 | 条件 | 效果 |
|---|---|---|
| 真正停止 | 终态 — MERGED / CLOSED | 看护结束 |
| 真正停止 | 看起来可以合并 — 7 项条件全部满足(见下) | 看护结束 |
| 真正停止 | 外部受阻已耗尽 — fork-PR CI 审批门,已排干 | 看护结束 |
| 真正停止 | 预算 — 活跃预算(默认 8h)或 3 天底线已达 | 看护结束 |
| 常驻残余 | needs-human | 阻塞 ready;不停止循环 |
| 常驻残余 | blocked-failing | 阻塞 ready;不停止循环 |
| 常驻残余 | stack-blocked | 阻塞 ready;不停止循环 |
"看起来可以合并" — 7 项条件必须全部满足
mergeability_certain+mergeable == "MERGEABLE"+merge_state_status == "CLEAN"base_ref_blocker == nullchecks_terminal为真(无仍在运行的任务)- 零可执行积压:
counts.threads == 0且counts.comments == 0 open_needs_human == 0(被延迟的"或未通知"线程不算 ready)branch_currency_blocker == nullquiet_seconds≥ settle 阈值(默认 300s),且"评审仍在路上"检查通过
Settle 窗口规则
- 300s 为默认。
- 不要预先放宽第一档——无论有没有评审 bot。
- 仅在被驳回的
merge-ready唤醒之后才能放宽。--settle-seconds 900单次延长至不超过1800。1800 是上限,证据不变时不得跨越它重新加注。 - Settle 窗口是冷却信号,不是"评审不会再来"的保证。
评审仍在路上检查(即判断)
Settle 窗口说 PR 不再活动;它不说没有评审在路上。看这些:
- 正文上的 👀 反应
- 顶层评论
- 针对该 head 的 check runs
- 针对该 head 的 reviews
一个已宣告(👀 / "reviewing…")但两边都没出东西的评审者,才是真正无法判定的情形。有限等待后,坦率说出你无法确认的内容。
GitLab 看护(mr-snapshot 帧生产者)
同一台看护引擎也运行在 GitLab 上。引擎本体(scripts/pr-snapshot)逐字节复用 GitHub 版、零改动;GitLab 侧只新增一个纯标准库 Python 的只读帧生产者 scripts/forge/mr-snapshot,经引擎既有的 --fetch-file 接缝把 GitLab 帧注入进来。分工从此分开:GitHub 侧引擎自己调 gh 取数;GitLab 侧引擎不吃网络——每拍读到什么,全部由帧文件说了算。
做任何 GitHub / GitLab 操作之前先加载共享 forge 模块:bash "$SKILL_DIR/scripts/forge/load.sh"。该脚本自动探测仓库 remote 的托管类型,把 glab/gh 包装器前置到 PATH;此后所有 PR/MR/CI 操作走 scripts/forge/{glab,gh}.ts 封装,不直接调用 gh/glab 二进制。封装以环境变量路由 host 与令牌(GITLAB_HOST / GITLAB_TOKEN),不用命令行旗标,令牌因此不出现在进程列表与命令历史里。
帧生产者:mr-snapshot daemon
GitLab 侧的帧由一个 daemon 常驻生产。每次看护用独立目录——MR 的 IID 只在项目内唯一,跨项目的并发看护不得共用帧与 stop 文件:
RUN_DIR=$(mktemp -d /tmp/ce-babysit-mr.XXXXXX)
SKILL_DIR="<ce-babysit-pr 技能目录绝对路径>"; PY=python3
"$PY" "$SKILL_DIR/scripts/forge/mr-snapshot" daemon \
  --mr <MR-URL> \
  --frame "$RUN_DIR/frame.json" \
  --interval 60 \
--stop-file "$RUN_DIR/stop" &- 帧写到
--frame路径,以 temp+fsync+rename 原子替换——消费者永远读不到半帧。 - 健康 sidecar 位于
<frame>.health:daemon 的 pid、tick 计数、last_success_at、last_error。 - 停止:
touch <stop-file>(与引擎 watch 共用同一个 stop 文件,引擎停则 daemon 停),或kill(SIGTERM 优雅退出)。
引擎消费:--fetch-file 组合
引擎所有子命令照 GitHub 版契约调用,只是 --fetch-file 指向 daemon 产的帧:
# 单拍
"$PY" "$SKILL_DIR/scripts/pr-snapshot" snapshot --pr <iid> \
  --repo <host>/<group>/<proj> --state-dir <state-dir> \
  --fetch-file "$RUN_DIR/frame.json" --start-invocation
# watch(与 daemon 共用 stop-file)
"$PY" "$SKILL_DIR/scripts/pr-snapshot" watch --pr <iid> \
  --repo <host>/<group>/<proj> --state-dir <state-dir> \
  --fetch-file "$RUN_DIR/frame.json" \
  --stop-file "$RUN_DIR/stop" \
  --invocation-id <id> --session-started-at <iso> --invocation-budget-seconds <n>
--repo 带 host 前缀,引擎按既有 [host/]owner/repo 规则拆分,state 目录隔离不变。mark 子命令也照上游:--thread 的 thread_id 就是 GitLab discussion id(帧 threads[].thread_id 原样透出),--check 的 key 是 pipeline 或 job:<name>。GitLab 下没有与 GitHub review-thread resolve mutation 等价的引擎通道;「解决讨论」是写操作,由 resolver 技能经 scripts/forge 封装完成,不在看护循环内。
帧龄即健康(陈旧不判 ready)
- 消费侧每拍从帧内
forge.producer.fetched_at读帧龄,不读 sidecar。 - 帧龄 ≤ 2× interval → 正常消费。
- 帧龄 > 2× interval → 该 tick 视为 not-ready,并在汇报中披露「快照过期,daemon 可能已死」;随后读 sidecar 的
last_error定位失败源。 - 任何 looks-ready 结论只允许来自帧龄新鲜且
mergeable=MERGEABLE/merge_state_status=CLEAN的帧。
状态映射:显式,不猜
帧的形态就是引擎的 GitHub 词汇。GitLab 的 detailed_merge_status 全部 26 个取值逐项显式映射(如 mergeable → MERGEABLE/CLEAN、conflict → CONFLICTING/DIRTY、need_rebase → MERGEABLE/BEHIND、not_approved → MERGEABLE/BLOCKED);映射表之外的新值一律诚实降级为 UNKNOWN/UNKNOWN,在帧的 forge.producer.unmapped_merge_status 里披露原始值并按 not-ready 处理——绝不弯折成某个已知状态。job / pipeline 状态同样逐项映射;manual 映射为 QUEUED,让检查保持非终态、settle 永不因它宣告 ready。
失败契约
任一源读取失败,整个 fetch 以非零退出:错误写进 sidecar,帧保持上一版,绝不落半帧或「字段在但为空」的伪帧——缺键会让引擎的 diff 在 KeyError 上大声失败,那才是合法路径;present-but-empty 则是编造事实。
与 GitHub 版的命令差异
| 上游锚点(GitHub) | GitLab 替代 |
|---|---|
入口探查 gh repo view | repoView()(glab repo view --output json);失败即报告并停止 |
tick 步骤 5 的 gh run rerun <run-id> --failed | pipelineRerun(pipelineId);pipeline id 从帧 forge.producer.head_pipeline_id 取,REST retry 覆盖 failed+canceled |
settle 描述刷新 gh pr edit | mrEdit(url, { bodyFile })(glab mr update --description-file) |
| 「评审仍在路上」只读查询 | api() 只读等价(读 discussions / notes 时间戳) |
推送凭据 gh auth git-credential | GITLAB_TOKEN 环境变量或 glab auth git-credential |
全部 gh stack * 与 stack-land 着陆步 | 硬禁用:GitLab 下无托管 stack(pr_chain.manager_status 恒 absent),提示改用 single MR |
常驻 needs-human 缺口
两个缺口是文档化的常驻现实,不由循环自动消除:
- manual job 触发:帧里恒 QUEUED 并由
forge.producer.manual_jobs_pending点名;daemon 与引擎都不自动触发,settle 时列为 needs-human。 - BEHIND rebase:帧的
host_branch_update_capability恒 false,branch-currency 的 BEHIND 项走既有 needs-human 路由;任何 rebase 不在本循环内。
契约文档与 drift 守卫
scripts/forge/gitlab-babysit-mapping.md 联合定义状态映射与命令点位:清单由对上游 gh/stack 触点的 grep 派生,不手工维护计数。drift 守卫的一个分支专门核对映射覆盖——ce-babysit-pr 散文里的每个 gh 触点都必须在映射文档里点名,未覆盖或文档缺失都让 CI 大声失败;另一侧则 pin 引擎契约,上游散文变动越出封装面时同样拦下。
报告
一行固定首行状态,然后是一段读者无需回翻就能据此合并的回顾:
✅ Looks merge-ready — <one-line evidence>. Your call to merge.
🟡 Cautiously looks ready — <evidence + caveats>
🎉 Merged — <one-line evidence>
🚫 Closed — <evidence>
⛔ Blocked — <evidence>
⏱️ Budget — <active|backstop, elapsed>
⏸️ Paused — <reason>
永远不要说 "safe to merge"(references/report.md)。回顾应点明反馈主题与结果、CI 修复、推送、运行时长、暂存项,以及为用户做的任何判断。
needs-human 契约
与 ce-debug 和 ce-resolve-pr-feedback 共享的类型化契约:
- Sources 用稳定 ID 列出每一项被覆盖的来源。
- decision_context 承载引用的反馈、调查过程、决策理由、选项与权衡,可空推荐。
- 当任一来源是线程时,thread_urls 非空。
- 编排器通过
pr-snapshot mark --residual-file <path> --disposition needs-human持久化;快照把完整来源集作为一份单元冻结。 - 对已覆盖来源的远端活动会让整份决策失效,并重新激活仍存活的来源。
- 人类答复通过
mark --answer-decision <id> --answer-file <path>记录;答复的状态迁移需要一次合法的状态写入才能消费。
防"狼来了"收敛
trajectory 字段是事实而非判定——看护把它们交给被委托的叶子,由叶子判断是否收敛:
| 触发器 | 含义 |
|---|---|
check_recur_max >= 2 | 同一个 check 一再复现 |
stream_alternations >= 3 | 线程与 CI 已交替 ≥3 次 |
上升的 unresolved_trend 且 new_threads_this_tick & &> 0 | 积压在上升的同时仍有新线程到达 |
heads_since_progress >= 2 | 两个 head SHA 之间未取得任何已 settle 的进展 |
当任一触发器命中时,在叶子做出变更之前把 trajectory 传给叶子;由叶子决定这是普通进展还是真正的非收敛。叶子可能返回一个 needs-human 残余,把整条流挂起(例如浮现的 CI 权衡、第三轮 invariant)。永远不要自己宣告非收敛。
自维持 vs 检点模式
看护支持两种执行模式:
- 自维持(默认):使用
pr-snapshot watch的会话内看护。每收到一次BABYSIT_WAKE跑一次 tick。唤醒原因:actionable、feedback-candidate、terminal、blocked-external、blocked-external-drained、blocked-failing、base-ref-blocked、unrequested-base-merge、downstack-actionable、stack-blocked、needs-human、settle 窗口后的merge-ready、max-runtime、stop-signal、invocation-superseded。 - 检点:跑一次 tick 并报告已暂停的监控及恢复调用。宿主在等待时无法保持会话活跃。
- 流水线(
mode:pipeline):有界同步 tick,结构化返回;无人等待。
预算算术
| 预算 | 上限 | 会重置吗? |
|---|---|---|
| 活跃看护时间 | 默认 8h(用户在入口可覆盖) | 重新加注与确认的托管 stack 层过渡必须匹配原始 ID、起始与预算——不重置,不延长 |
| 墙钟底线 | 3 个日历日 | 从不重置(兜底) |
| 死时排除 | 挂起时间(合盖等)从活跃预算中扣除 | 粗粒度检测:宽于阈值的间隔视为死时 |
重新加注会保留 last_change_at、invocation_started_at 与 invocation_budget_seconds——任一计时器都不能被重启或延长。
参考
references/tick.md— 完整的快照/watch/marks/顺序契约references/settle.md— 停止条件、settle 窗口、"评审仍在路上"判断references/branch-currency.md— BEHIND/DIRTY 机制与缺陷检测器references/stack.md— 托管 stack:姿态、发现、过渡、合入references/stack-commands.md—gh stackCLI 配方references/pipeline.md— pipeline 模式的有界停止与残余契约references/envelope.md— 完整边界、授权、诚实契约陈述references/setup.md— 步骤 1:伪造检查、PR 解析、链分类references/intake.md— 旧 PR 归属判断、三选一判定、verified update 与改写授权references/takeover.md— 用户要求接管 PR 时的处理references/watch-loop.md— watch 循环调度、状态、跨宿主去重references/report.md— 报告格式scripts/pr-snapshot— Python(3,656 行);argparse 含 snapshot/mark/watch 子命令scripts/intake-overlap— intake 用的重叠检查(只读)